Övervaka, gör om och spela upp varje integration från en plattform

Läs mer
A Alumio vivid purple arrow pointing to the right, a visual representation of how to access more page material when clicking on it.
Gå tillbaka

Katastrofåterställningsplanering vid integrationsfel

Av
Saad Merchant
Publicerad den
October 2, 2026
Uppdaterad den
October 2, 2026
I SAMTAL MED
Email icon
Email icon

En katastrofplan beskriver vanligtvis vad som händer när en server går ner, en databas blir korrupt eller ett datacenter slocknar. Den anger mål för återställningstid (RTO), mål för återställningspunkt (RPO) och vem som ansvarar för att deklarera en incident. Den beskriver sällan vad som händer när alla system körs men anslutningarna mellan dem inte gör det. En tillverkare vars affärssystem (ERP) och MES-system båda fungerar kan fortfarande inte skicka ut arbetsordrar till fabriksgolvet om integrationen som hanterar produktionsordrar har stannat. Fabriken märker ingen skillnad, och det gör inte heller kunden som väntar på sin order. Företag täpper till denna lucka genom att flytta dessa anslutningar till en integrationsplattform (iPaaS). Ett fel där blir synligt, data som var under överföring bevaras och flödet återupptas där det stannade. Återställning innebär då att spela upp det som låg i kö istället för att återskapa det som gått förlorat.

Vad katastrofplanen oftast missar

Återställningsplanering följer företagets inventarielista. Servrar, databaser, applikationer och nätverkslänkar finns med på listan, var och en med en ägare och ett återställningsmål. Integrationer hamnar sällan på den listan, eftersom ingen har köpt dem som en enskild produkt.

En punkt-till-punkt-anslutning mellan ett affärssystem och ett lagersystem är ofta ett skript på en server eller ett schemalagt jobb i ett system som ingen har det fulla ansvaret för. Det saknar licens, leverantör och ofta även dokumentation. När katastrofplanen skrevs var den inte tillräckligt synlig för att inkluderas.

Luckan visar sig genom fyra frågor som ingen kan besvara under en incident:

  • Vad var under överföring: vilka ordrar, leveranser eller produktionsinstruktioner som hade lämnat ett system men inte anlänt till det andra när anslutningen bröts
  • Om något gick förlorat: om dessa poster ligger i kö och väntar, eller om de helt enkelt är borta
  • Vem startar om den: vilket team som äger anslutningen, till skillnad från att äga de två systemen i vardera ände
  • I vilken ordning ska omstart ske: om affärssystemet måste vara igång innan lagersystemets flöde återupptas, eller tvärtom

Var och en av dessa frågor kan besvaras i förväg. Ingen av dem går att besvara under ett avbrott om det inte finns nedskrivet, vilket är anledningen till att den första timmen av en integrationsincident oftast går åt till att förstå vad som hänt snarare än att återställa det.

Varför märks inte integrationsfel?

En trasig server märks direkt. Användare kan inte logga in, instrumentpaneler lyser rött och någon larmas inom några minuter. Ett integrationsfel är tystare, eftersom alla system som den kopplar samman fortfarande körs som vanligt.

Webbutiken tar fortfarande emot ordrar. Affärssystemet visar fortfarande gårdagens lagersaldo. Lagret plockar fortfarande det de blev tillsagda att plocka för en timme sedan. Ingenting är trasigt ur något enskilt systems perspektiv, och ingenting kommer att vara det förrän datagapet blir tillräckligt stort för att någon ska märka det.

Det är därför integrationsfel oftast rapporteras av kunder snarare än av övervakningssystem. En köpare frågar var deras order är, och någon upptäcker att orderflödet stannade klockan 02:00. Att upptäcka detta tidigare är uppgiften för övervakning och loggning, vilket är en annan disciplin än att återställa systemet när felet väl är känt.

Vad en timmes driftstopp i integrationen kostar

Kostnaden för ett integrationsavbrott är inte proportionell mot dess längd. Den är proportionell mot hur mycket verksamheten är beroende av flödet och hur länge felet förblir oupptäckt:

  • En produktionslinje som väntar på arbete: ett MES-system utan nya order eftersom ERP-kopplingen ligger nere, och ett skift som får betalt medan de väntar
  • Order som tas emot för lager som inte finns: en butik som säljer i fyra timmar baserat på den senaste siffran den tog emot
  • Leveranser som aldrig når transportören: leveransinstruktioner som ligger i kö i ett system ingen övervakar, och som upptäcks nästa morgon
  • Dubbletter efter omstart: ett flöde som startas om utan att veta vad som redan gått igenom, vilket skapar en kopia av varje order som fastnade i glappet
  • Avstämning som tar dagar: ekonomiavdelningen som jämför två system manuellt för att hitta vad som flyttats och vad som inte gjort det

Det fjärde alternativet är den dyra överraskningen. Att starta om en anslutning är enkelt. Att starta om den utan att duplicera eller missa det som var under bearbetning kräver att man vet exakt var det stannade, och de flesta punkt-till-punkt-anslutningar loggar inte det.

Förvandla AI-ambition till handling

Portrait of Leonie Becher Merli, Business Development Manager at Alumio

Få en kostnadsfri bedömning av dina integrationsbehov

Portrait of Leonie Becher Merli, Business Development Manager at Alumio

Håll integrationer återställningsbara på en styrd integrationsplattform

Håll integrationer återställningsbara på en styrd integrationsplattform

Varför återställning är svårare utan ett enhetligt integrationslager

När varje anslutning byggs separat blir återställningen en separat övning för var och en. Skriptet mellan affärssystemet och lagret har sin egen omstartsprocedur, skriven av den som byggde det. Flödet till marknadsplatsen har ett annat. Inget av dem är dokumenterat tillsammans med det andra, och personen som vet hur det ena fungerar är ledig just den veckan.

Resiliens byggs också ojämnt. En anslutning gör ett nytt försök vid fel, en annan ger upp i tysthet och en tredje skriver till en logg som ingen läser. Det finns inget sätt att fastställa ett mål för återställningstid för anslutningar som alla beter sig olika.

De flesta företag hamnar i denna situation av en slump snarare än genom ett aktivt beslut. Anslutningar lades till en i taget, var och en brådskande, och byggdes av den som fanns tillgänglig. Resultatet är en miljö där återställningsplanen täcker varje system, men ingen av länkarna mellan dem.

Hur en integrationsplattform stöder katastrofåterställning

En integrationsplattform som tjänst (iPaaS) ger ett företag en central plats där alla system ansluts. Varje system ansluter till den en gång istället för att ansluta direkt till varandra, och plattformen flyttar och omformar data mellan dem. Tillverkare använder den redan för det dagliga arbetet: att skicka produktionsorder från affärssystemet till MES, rapportera färdigställande och kassation, samt skicka leveransdata till en transportör.

Återställningen bygger på samma upplägg. Flödena är samlade istället för utspridda i olika skript, vilket innebär att det bara finns en sak att övervaka, en plats där data under överföring väntar och en omstartsprocedur istället för tjugo.

Integrationsplattformen Alumio erbjuder funktioner som kan konfigureras för att göra integrationer återställningsbara. Fyra av dem gör det mesta av arbetet:

  • Lagrade meddelanden: Lagring inom Alumio kan hålla kvar data som var under överföring, så att ett fel blir en kö att arbeta igenom istället för en uppsättning poster som ingen kan redogöra för.
  • Återuppspelning från tidpunkten för felet: ett flöde kan köras på nytt mot de lagrade meddelandena när det mottagande systemet är i drift igen, vilket undviker både dubbletter och luckor.
  • Automatiskt nytt försök med definierat beteende: varje rutt kan konfigureras med sin egen hantering av nya försök och fel, så att ett kort avbrott vid en slutpunkt inte kräver mänsklig inblandning.
  • Status synlig i en vy: övervakning av alla flöden innebär att en stoppad anslutning upptäcks på några minuter istället för när en kund ringer.

Samma upplägg håller e-handelsintegrationer hållbara vid hög volym, av samma anledning. Att lägga till en anslutning utökar det som redan finns istället för att lägga till ytterligare en sak att komma ihåg vid en incident.

Vad ett återställningsbart integrationslager ger verksamheten

Återställningsplanering tenderar att betrakta integrationer som VVS som antingen fungerar eller inte. I praktiken bär de på instruktionerna som håller en fabrik igång och en butik korrekt, och de fallerar oftare än systemen i vardera ände.

En integrationsplattform gör dessa kopplingar planerbara. Den sparar det som var under överföring, återupptar arbetet där det avbröts och visar status för varje flöde i en och samma vy. Ett återställningsmål kan då fastställas istället för att bara hoppas på det bästa.

Företaget får kortare driftstopp, en avstämning som tar minuter istället för dagar, och ett svar när en revisor frågar vad som hände med de beställningar som gjordes under avbrottet.

Inga objekt hittades.

FAQ

Integration Platform-ipaas-slider-right
Vad är en katastrofåterställningsplan för integrationer?

En katastrofåterställningsplan för integrationer beskriver vad som händer när kopplingarna mellan systemen fallerar, till skillnad från systemen i sig. Den täcker hur ett fel upptäcks, vad som händer med data som var under överföring, vem som startar om flödet, i vilken ordning, och hur verksamheten efteråt verifierar att ingenting dubblerades eller gick förlorat. De flesta planer omfattar servrar och databaser men lämnar kopplingarna mellan dem odefinierade.

Integration Platform-ipaas-slider-right
Varför lämnas integrationer utanför återställningsplaneringen?

Därför att de sällan syns som tillgångar. En punkt-till-punkt-koppling är vanligtvis ett skript eller ett schemalagt jobb utan licens, leverantör eller ägare i tillgångsregistret. Återställningsplaner byggs utifrån det registret, så kopplingarna syns inte. Glappet blir uppenbart först vid en incident, när ingen kan säga vilket team som äger flödet som stannade.

Integration Platform-ipaas-slider-right
Vad händer med data under överföring när en integration fallerar?

Det beror helt på hur kopplingen har byggts. Vissa gör om försöket, vissa köar, och vissa kastar posten i tysthet. Där meddelanden behålls av integrationslagret blir felet en backlog som kan spelas upp på nytt när det mottagande systemet har återhämtat sig. Där de inte behålls måste verksamheten manuellt återskapa vad som flyttats genom att jämföra båda systemen.

Integration Platform-ipaas-slider-right
Hur hjälper en integrationsplattform till med kontinuitetsplanering?

En integrationsplattform som tjänst (iPaaS) kan konfigureras för att behålla meddelanden som var under överföring, automatiskt göra om försök vid tillfälliga fel och spela upp ett flöde från den punkt där det stannade när slutpunkten är frisk. Varje flöde körs på ett ställe, så det finns en enhetlig övervakningsvy och en enhetlig omstartsprocedur istället för en per koppling. Det är det som gör ett fastställt återställningsmål realistiskt.

Integration Platform-ipaas-slider-right
Vad är risken med att starta om en integration efter ett avbrott?

Dubblering och utelämnande, i ungefär lika stor utsträckning. Att starta om utan att veta exakt vilka poster som redan bearbetats kan skapa en kopia av varje beställning i glappet, eller hoppa över dem helt. För att undvika båda krävs att kopplingen registrerar var den stannade, vilket punkt-till-punkt-skript ofta inte gör.

Integration Platform-ipaas-slider-right
Bör integrationer ha ett eget mål för återställningstid?

Ja, och det bör spegla vad flödet innehåller snarare än att vara en generell siffra. Ett lagerflöde per timme och en produktionsorder har mycket olika tolerans för fördröjning. Att sätta ett mål per flöde tvingar också fram den viktiga frågan om vem som äger varje koppling, vilket ofta är det som en incident avslöjar att ingen har bestämt.

Få en kostnadsfri bedömning av dina integrationsbehov

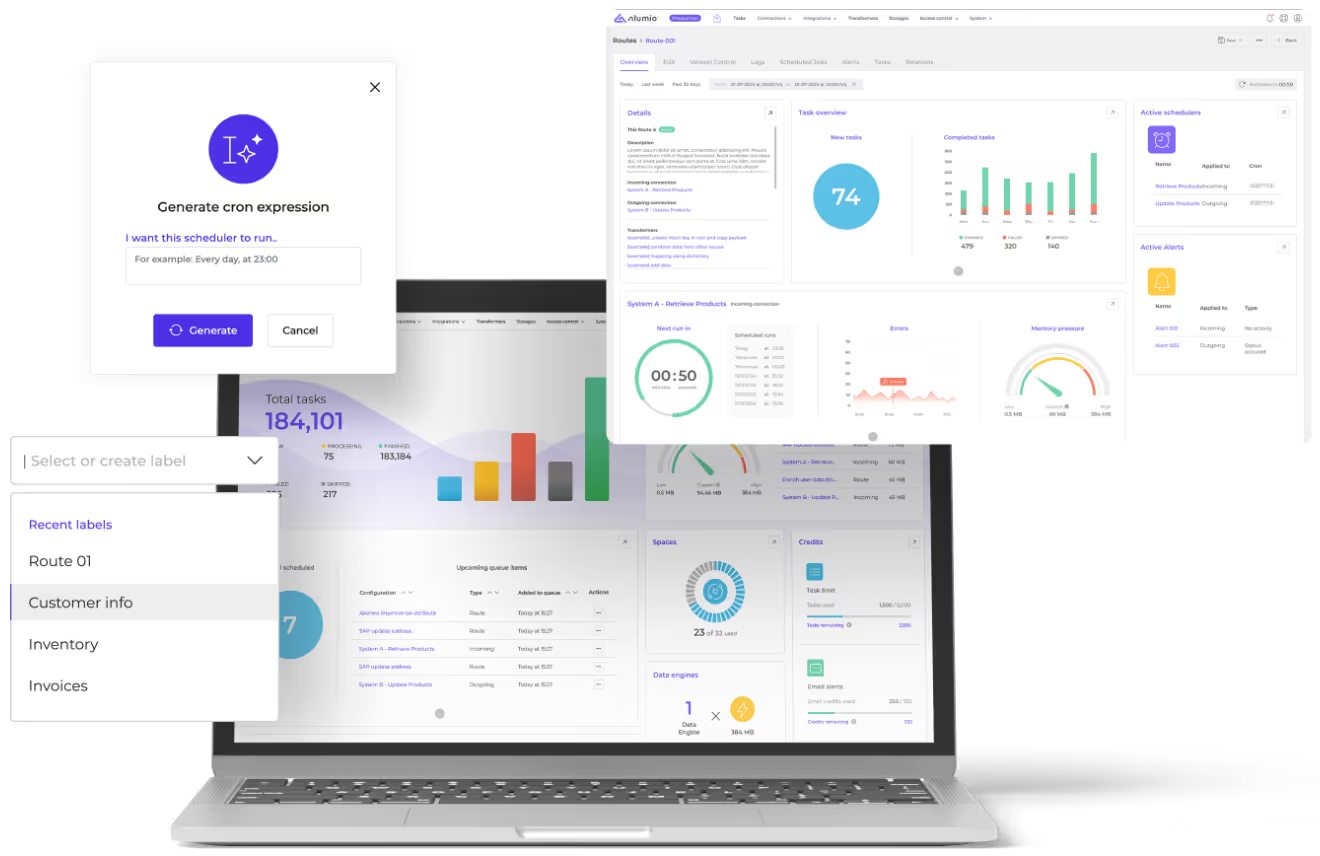
Laptop screen displaying the Alumio iPaaS dashboard, alongside pop-up windows for generating cron expressions, selecting labels and route overview.