Lo que un plan de recuperación ante desastres suele omitir
La planificación de la recuperación sigue la estructura del registro de activos de una empresa. Los servidores, bases de datos, aplicaciones y enlaces de red aparecen en una lista, cada uno con un responsable y un objetivo de recuperación. Las integraciones rara vez aparecen en esa lista, porque nadie las adquirió como un activo independiente.
Una conexión punto a punto entre un ERP y un sistema de almacén es un script en algún servidor o una tarea programada en un sistema que nadie gestiona directamente. No tiene licencia, ni proveedor y, a menudo, carece de documentación. Cuando se redactó el plan de recuperación, no era lo suficientemente visible como para incluirlo.
La brecha se manifiesta en cuatro preguntas que nadie puede responder durante un incidente:
- Qué estaba en tránsito: qué pedidos, envíos o instrucciones de producción habían salido de un sistema y no habían llegado al otro cuando la conexión se detuvo
- Si se perdió algo: si esos registros están en cola esperando, o si simplemente han desaparecido
- Quién lo reinicia: qué equipo es responsable de la conexión, en lugar de ser responsable de los dos sistemas en cada extremo
- En qué orden reiniciar: si el ERP debe estar operativo antes de reanudar la alimentación del almacén, o viceversa
Cada una de estas preguntas puede responderse de antemano. Ninguna de ellas puede responderse durante una interrupción si nadie lo dejó por escrito, razón por la cual la primera hora de un incidente de integración suele dedicarse al descubrimiento en lugar de a la recuperación.
¿Por qué pasan desapercibidos los fallos de integración?
Un servidor caído se hace notar. Los usuarios no pueden iniciar sesión, los paneles de control se ponen en rojo y alguien recibe un aviso en cuestión de minutos. Una integración fallida es más silenciosa, porque todos los sistemas que conecta siguen funcionando con normalidad.
La tienda sigue aceptando pedidos. El ERP sigue mostrando el stock de ayer. El almacén sigue preparando lo que se le indicó hace una hora. Nada parece roto desde el punto de vista de cada sistema individual, y nada lo estará hasta que la brecha de datos sea lo suficientemente grande como para que alguien lo note.
Por eso, los fallos de integración suelen ser reportados por los clientes en lugar de por el sistema de monitorización. Un comprador pregunta dónde está su pedido y alguien descubre que el flujo de pedidos se detuvo a las 02:00. Detectarlo antes es trabajo de monitorización y registro, que es una disciplina distinta a la recuperación una vez que el fallo ya se conoce.
Lo que cuesta una hora de inactividad en la integración
El coste de la inactividad en la integración no es proporcional a su duración. Es proporcional a cuánto depende el negocio de ese flujo y cuánto tiempo pasa el fallo sin ser detectado:
- Una línea de producción esperando trabajo: un MES sin nuevos pedidos porque la conexión con el ERP se detuvo, y un turno pagado mientras espera
- Pedidos realizados sobre stock inexistente: una tienda vendiendo durante cuatro horas basándose en la última cifra recibida
- Envíos que nunca llegan al transportista: instrucciones de despacho en cola en un sistema que nadie supervisa, descubiertas a la mañana siguiente
- Registros duplicados tras el reinicio: un flujo reiniciado sin saber qué se procesó anteriormente, creando una segunda copia de cada pedido durante el intervalo de inactividad
- Conciliaciones que llevan días: el departamento financiero comparando dos sistemas manualmente para encontrar qué se movió y qué no
El cuarto punto es la sorpresa costosa. Reiniciar una conexión es fácil. Reiniciarla sin duplicar ni omitir lo que estaba en curso requiere saber exactamente dónde se detuvo, y la mayoría de las conexiones punto a punto no registran esa información.
Por qué la recuperación es más difícil sin una capa de integración única
Cuando cada conexión se construye de forma independiente, la recuperación se convierte en un ejercicio distinto para cada una. El script entre el ERP y el almacén tiene su propio procedimiento de reinicio, escrito por quien lo creó. La fuente de datos para el marketplace tiene otro. Ninguno está documentado junto al otro, y la persona que sabe cómo funciona uno no está disponible esa semana.
La resiliencia también se construye de manera desigual. Una conexión vuelve a intentarlo tras un fallo, otra se rinde silenciosamente y una tercera escribe en un registro que nadie lee. No hay forma de establecer un objetivo de tiempo de recuperación para conexiones que se comportan de manera diferente.
La mayoría de las empresas llegan a este punto por accidente y no por decisión. Las conexiones se añadieron una a una, cada una con urgencia y creada por quien estuviera disponible. El resultado es un entorno donde el plan de recuperación cubre todos los sistemas, pero ninguno de los enlaces entre ellos.
Cómo una plataforma de integración facilita la recuperación ante desastres
Una plataforma de integración como servicio (iPaaS) ofrece a la empresa un lugar centralizado donde conectar todos sus sistemas. Cada sistema se conecta a ella una sola vez en lugar de hacerlo directamente con los demás, y la plataforma mueve y adapta los datos entre ellos. Los fabricantes ya la utilizan para sus operaciones diarias: trasladar órdenes de producción del ERP al MES, devolver registros de finalización y desechos, y enviar datos de envío a un transportista.
La recuperación funciona bajo ese mismo esquema. Los flujos residen juntos en lugar de estar dispersos en scripts, por lo que hay un solo punto de monitoreo, un lugar donde los datos en tránsito esperan y un único procedimiento de reinicio en lugar de veinte.
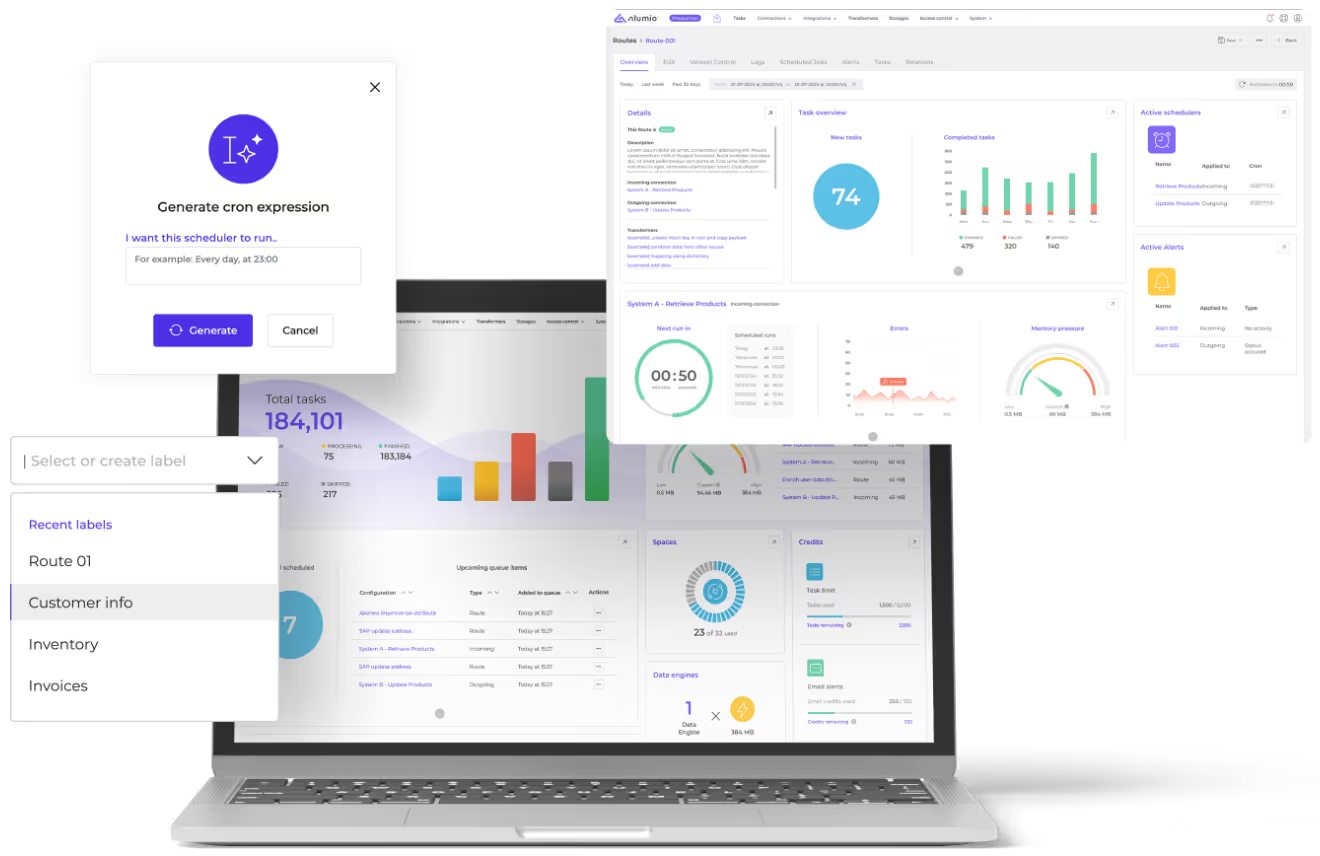
La plataforma de integración Alumio ofrece funciones que pueden configurarse para hacer que las integraciones sean recuperables. Cuatro de ellas realizan la mayor parte del trabajo:
- Mensajes retenidos: El almacenamiento dentro de Alumio puede retener los datos que estaban en tránsito, de modo que un fallo se convierte en una cola de trabajo pendiente en lugar de un conjunto de registros que nadie puede localizar.
- Reintento desde el punto de fallo: un flujo puede volver a ejecutarse utilizando los mensajes retenidos una vez que el sistema receptor esté operativo, lo que evita tanto duplicados como vacíos de información.
- Reintento automático con comportamiento definido: cada ruta puede configurarse con su propio manejo de reintentos y errores, de modo que una breve interrupción en un punto final no requiera intervención humana.
- Estado visible en una sola vista: el monitoreo de todos los flujos permite detectar una conexión detenida en cuestión de minutos, en lugar de esperar a que un cliente llame para avisar.
Esa misma estructura mantiene las integraciones de comercio electrónico sostenibles a gran escala, por la misma razón. Añadir una conexión amplía lo que ya existe en lugar de añadir un elemento más que recordar durante una incidencia.
Lo que una capa de integración recuperable aporta al negocio
La planificación de la recuperación suele tratar las integraciones como tuberías que funcionan o no. En la práctica, estas transportan las instrucciones que mantienen una planta en funcionamiento y una tienda en orden, y fallan con más frecuencia que los sistemas que conectan.
Una plataforma de integración hace que esas conexiones sean planificables. Retiene lo que estaba en tránsito, se reanuda desde donde se detuvo y muestra el estado de cada flujo en una sola vista. De este modo, el objetivo de recuperación puede definirse con precisión en lugar de dejarse al azar.
La empresa termina con una interrupción más corta, una conciliación que toma minutos en lugar de días y una respuesta clara cuando un auditor pregunta qué sucedió con los pedidos realizados durante el periodo de inactividad.