Wat een disaster recovery-plan meestal over het hoofd ziet
Herstelplanning volgt de structuur van het activaregister van een bedrijf. Servers, databases, applicaties en netwerkverbindingen staan allemaal op een lijst, elk met een eigenaar en een hersteldoel. Integraties staan zelden op die lijst, omdat niemand ze als een afzonderlijk product heeft aangeschaft.
Een point-to-point verbinding tussen een ERP en een magazijnsysteem is vaak een script op een server of een geplande taak in een systeem waar niemand de volledige verantwoordelijkheid voor draagt. Er is geen licentie, geen leverancier en vaak geen documentatie. Toen het herstelplan werd geschreven, was de verbinding niet zichtbaar genoeg om op te nemen.
Dit gat leidt tot vier vragen die tijdens een incident niemand kan beantwoorden:
- Wat was onderweg: welke orders, zendingen of productie-instructies hadden het ene systeem verlaten, maar waren nog niet aangekomen in het andere toen de verbinding stopte
- Of er iets verloren is gegaan: of die records ergens in de wachtrij staan te wachten, of dat ze simpelweg verdwenen zijn
- Wie het herstart: welk team eigenaar is van de verbinding, in tegenstelling tot het eigenaarschap van de twee systemen aan weerszijden
- In welke volgorde herstarten: of het ERP gezond moet zijn voordat de magazijnfeed wordt hervat, of andersom
Elk van deze vragen kan vooraf worden beantwoord. Tijdens een storing is geen van deze vragen te beantwoorden als niemand het heeft vastgelegd; daarom wordt het eerste uur van een integratie-incident meestal besteed aan uitzoeken in plaats van aan herstellen.
Waarom blijven integratiefouten onopgemerkt?
Een defecte server kondigt zichzelf aan. Gebruikers kunnen niet inloggen, dashboards kleuren rood en binnen enkele minuten wordt er iemand opgeroepen. Een mislukte integratie is stiller, omdat elk systeem dat ermee verbonden is, nog steeds normaal functioneert.
De webshop accepteert nog steeds bestellingen. Het ERP toont nog steeds de voorraad van gisteren. Het magazijn pikt nog steeds wat het een uur geleden moest pikken. Vanuit het perspectief van elk afzonderlijk systeem is er niets aan de hand, en dat blijft zo totdat het datagat groot genoeg is geworden voor een mens om het op te merken.
Daarom worden integratiefouten meestal door klanten gemeld in plaats van door monitoring. Een koper vraagt waar zijn bestelling blijft, en iemand ontdekt dat de bestelstroom om 02:00 uur is gestopt. Het eerder detecteren hiervan is de taak van monitoring en logging, wat een andere discipline is dan herstel zodra de fout bekend is.
Wat een uur integratie-uitval kost
De kosten van integratie-uitval zijn niet evenredig aan de duur ervan. Ze zijn evenredig aan de mate waarin het bedrijf afhankelijk is van de stroom en hoe lang de fout onopgemerkt blijft:
- Een productielijn die wacht op werk: een MES zonder nieuwe orders omdat de ERP-verbinding is weggevallen, terwijl een ploeg wordt doorbetaald terwijl ze wachten
- Orders aannemen voor voorraad die er niet is: een webshop die vier uur lang verkoopt op basis van de laatst ontvangen voorraadcijfers
- Zendingen die de vervoerder nooit bereiken: verzendinstructies die in een systeem blijven staan waar niemand naar kijkt, en pas de volgende ochtend worden ontdekt
- Dubbele records na de herstart: een stroom die opnieuw wordt opgestart zonder te weten wat er al doorheen was gekomen, waardoor er van elke order in de tussenliggende periode een tweede kopie ontstaat
- Reconciliatie die dagen duurt: de financiële afdeling die handmatig twee systemen vergelijkt om te achterhalen wat er wel en niet is verwerkt
De vierde is de dure verrassing. Een verbinding herstarten is eenvoudig. Deze herstarten zonder dubbele of gemiste gegevens vereist dat je precies weet waar het proces is gestopt, en de meeste point-to-point-verbindingen leggen dat niet vast.
Waarom herstel lastiger is zonder een centrale integratielaag
Wanneer elke verbinding afzonderlijk wordt opgebouwd, is herstel voor elk ervan een aparte oefening. Het script tussen het ERP en het magazijn heeft zijn eigen herstartprocedure, geschreven door degene die het heeft gebouwd. De feed naar de marktplaats heeft er weer een andere. Geen van beide is gedocumenteerd in samenhang met de andere, en de persoon die weet hoe het werkt, is die week afwezig.
Veerkracht wordt ook ongelijkmatig opgebouwd. De ene verbinding probeert het opnieuw bij een fout, de andere geeft het stilletjes op en een derde schrijft naar een logboek dat niemand leest. Er is geen manier om een doelstelling voor de hersteltijd vast te stellen voor verbindingen die zich elk anders gedragen.
De meeste bedrijven bereiken dit punt per ongeluk in plaats van door een bewuste beslissing. Verbindingen werden één voor één toegevoegd, elk dringend, elk gebouwd door wie er op dat moment beschikbaar was. Het resultaat is een landschap waarin het herstelplan elk systeem dekt, maar geen van de koppelingen daartussen.
Hoe een integratieplatform disaster recovery ondersteunt
Een integration platform-as-a-service (iPaaS) biedt een bedrijf één centrale plek waar alle systemen samenkomen. Elk systeem maakt één keer verbinding met het platform in plaats van rechtstreeks met elkaar, en het platform verplaatst en transformeert de data tussen de systemen. Fabrikanten gebruiken dit al voor hun dagelijkse werkzaamheden: het doorgeven van productieorders van het ERP naar het MES, het terugkoppelen van voltooide producten en uitval, en het versturen van verzendgegevens naar een vervoerder.
Herstel verloopt volgens diezelfde opzet. De datastromen staan bij elkaar in plaats van verspreid over verschillende scripts, waardoor er één punt is om te monitoren, één plek waar data in afwachting staat en één herstartprocedure in plaats van twintig.
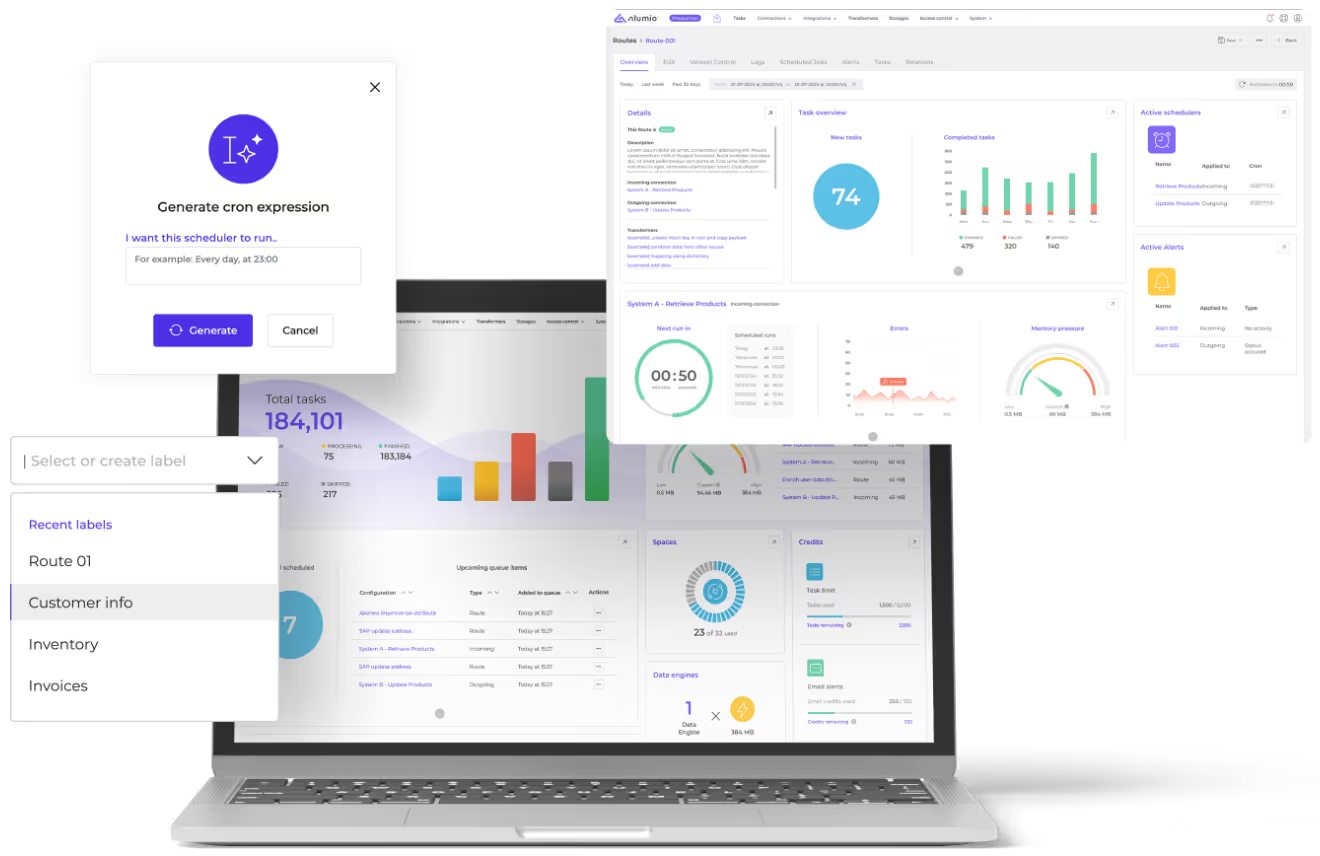
Het Alumio-integratieplatform biedt functies die geconfigureerd kunnen worden om integraties herstelbaar te maken. Vier daarvan doen het meeste werk:
- Bewaarde berichten: Opslag binnen Alumio kan de data die in verwerking was vasthouden, zodat een storing verandert in een wachtrij die kan worden weggewerkt, in plaats van een set records waar niemand meer zicht op heeft.
- Opnieuw afspelen vanaf het punt van uitval: een datastroom kan opnieuw worden uitgevoerd met de bewaarde berichten zodra het ontvangende systeem weer gezond is, wat zowel dubbele gegevens als hiaten voorkomt.
- Automatisch opnieuw proberen met gedefinieerd gedrag: elke Route kan worden geconfigureerd met eigen instellingen voor opnieuw proberen en foutafhandeling, zodat een korte storing bij één eindpunt helemaal geen menselijk ingrijpen vereist.
- Status zichtbaar in één overzicht: monitoring over alle datastromen heen betekent dat een gestopte verbinding binnen enkele minuten wordt opgemerkt, in plaats van pas wanneer een klant belt.
Dezelfde opzet houdt e-commerce-integraties duurzaam bij grote volumes, om dezelfde reden. Het toevoegen van een verbinding breidt het bestaande systeem uit in plaats van dat er weer iets nieuws bijkomt om te onthouden tijdens een incident.
Wat een herstelbare integratielaag het bedrijf oplevert
Bij herstelplanning worden integraties vaak behandeld als leidingwerk dat wel of niet werkt. In de praktijk bevatten ze de instructies die een fabriek draaiende houden en een webshop betrouwbaar maken, en ze vallen vaker uit dan de systemen aan beide uiteinden.
Een integratieplatform maakt die verbindingen planbaar. Het houdt vast wat onderweg was, hervat waar het stopte en toont de status van elke flow in één overzicht. Een hersteldoelstelling kan dan worden vastgelegd in plaats van er slechts op te hopen.
Het bedrijf heeft uiteindelijk een kortere uitvaltijd, een afstemming die minuten in plaats van dagen duurt, en een antwoord wanneer een auditor vraagt wat er is gebeurd met de bestellingen die tijdens de onderbreking zijn geplaatst.