Varför integrationstestning avgör vad som går sönder efter lansering
En integration är en koppling som överför poster mellan två system som aldrig designades för att prata med varandra. En order som läggs i en Adobe Commerce-butik måste nå SAP som något som ekonomiavdelningen kan fakturera. En lagersiffra i SAP måste nå butiken innan en kund köper något som inte längre finns i lager.
Integrationstestning säkerställer att detta utbyte fungerar innan det börjar hantera riktiga order. Det liknar vanlig mjukvarutestning med fler rörliga delar, men de flesta av dessa delar tillhör någon annan.
När ett team hoppar över detta är det inte IT-avdelningen som märker det först. Lagret märker det, kundtjänst märker det och ekonomiavdelningen märker det vid månadsskiftet:
- En order som flödet aldrig har sett: en kreditnota eller en delleverans når SAP i ett format som mappningen inte förväntar sig. Flödet stannar, och kunden förblir obetalad tills någon upptäcker felet.
- Ett lagerflöde som tyst slutar fungera: butiken visar gårdagens lagersaldo i tjugo minuter, och lagerpersonalen letar efter varor som redan är sålda.
- En marknadsplats som ändrat ett fält: Amazon börjar kräva ett attribut som produktdata aldrig skickade, avvisar listningarna, och produkterna försvinner från kanalen.
- En belastningstopp ingen dimensionerat för: ett flöde som testats för tio order i timmen möter fyra tusen under årets största försäljningsdag och får timeout, med order i köer som ingen övervakar.
Inget av detta är ovanligt. Varje scenario hade kunnat testas i förväg. De flesta team gör det inte, eftersom hälften av systemen som är inblandade inte är deras egna att experimentera med.
Varför integrationer inte kan testas som vanlig programvara
Leverantörens sandlådemiljö kanske inte existerar. Om den gör det kan den innehålla tre år gammal data som inte liknar det som körs nu. Att testa i en sandlådemiljö som skiljer sig från produktionsmiljön ger mindre än vad det verkar.
Integrationer förändrar också saker när de körs. Det första testet skapar en order, använder ett nummer i en sekvens eller flyttar lager, vilket gör att samma test inte bara kan köras igen. Att upprepa det innebär att systemen måste återställas, vilket oftast är omöjligt, eller att ny data måste genereras varje gång. De förhållanden som är mest värda att testa är också de som ingen tillåter. En leverantör kommer inte att ta sitt system offline bara för att teamet ska kunna testa felhanteringen. En transportör kommer inte att strypa ett API på begäran. Dessa scenarier simuleras därför, eller så hoppas de över helt.
Ett tillstånd kan aldrig testas alls. En leverantör kan ändra ett fält utan att meddela någon, och den ändringen har inte skett när testplanen skrivs. För att upptäcka det behöver teamet övervakning och loggning. Testning bevisar att ett flöde fungerar innan det går live. Övervakning berättar för teamet vad den faktiska trafiken gör med det efteråt. Allt däremellan beror på en sak: om testmiljön var tillräckligt lik produktionsmiljön för att vara värd att lita på.
Varför testmiljön är där integrationstestning kör fast
Det mesta av arbetet vid systemintegrationstestning läggs på miljön, inte på själva testerna. Där varje anslutning är anpassad kod innebär en testmiljö att man kör en andra kopia av koden, riktad mot de leverantörssandlådor som finns, och håller den i takt med produktionen medan båda sidor förändras.
Det underhållet är anledningen till att testmiljöer driver iväg. Versionen som testas slutar matcha versionen som körs, och testerna slutar bevisa någonting.
Att konfigurera flödena i ett gemensamt integrationslager eliminerar det problemet. Samma flödesdefinition körs i båda miljöerna. Den pekar mot testslutpunkter i den ena och live-slutpunkter i den andra, och endast konfigurationen skiljer sig åt. Leverantörernas sandlådor blir inte bättre av det, men teamet slutar distribuera något annat än det som faktiskt testats.
Team hanterar detta på tre sätt idag. De bygger en fullständig parallell miljö, vilket är grundligt men dyrt att hålla uppdaterat. De testar i produktion mot poster de valt ut noggrant, vilket fungerar fram till dess att den valda posten visar sig vara kritisk. Eller så simulerar de varje externt system, vilket går snabbt men bara testar det teamet antar att leverantören kommer att skicka. En integrationsplattform som tjänst (iPaaS) är det fjärde alternativet, och det enda som eliminerar miljöproblemet istället för att försöka kringgå det.
Hur en integrationsplattform stödjer integrationstestning
En iPaaS är en enhetlig plattform som alla system ansluter till en gång, istället för att ansluta direkt till varandra. Den innehåller flödena som flyttar och omformar data mellan dem. Eftersom varje flöde ligger på en plats kan ett team peka det mot testslutpunkter eller live-slutpunkter utan att behöva bygga om någonting.
Det gör fyra saker möjliga på Alumio-integrationsplattformen:
- Ett flöde, två miljöer: samma konfigurerade flöde körs mot testslutpunkter i en testmiljö och mot live-slutpunkter i produktion, så att teamet distribuerar exakt det som har kontrollerats
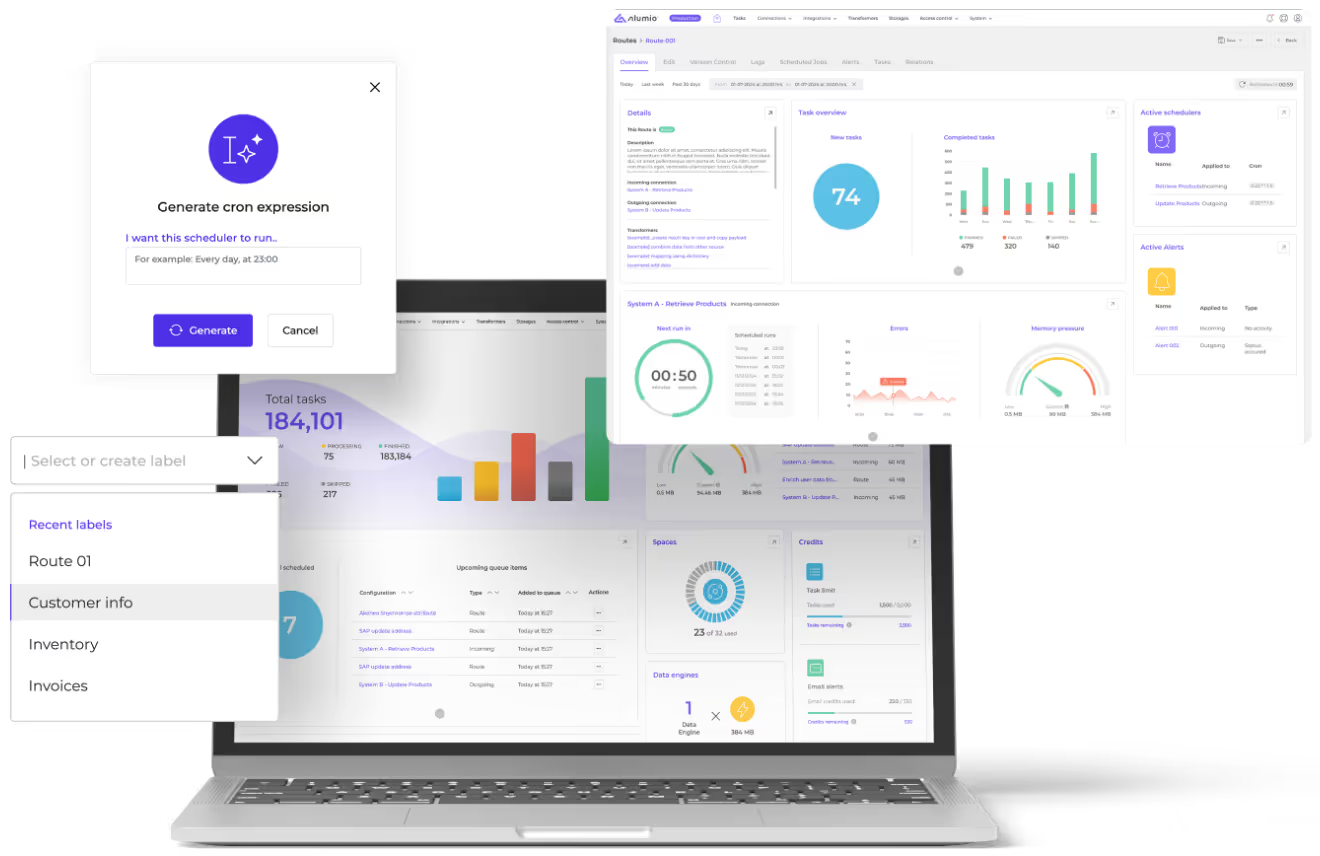
- Detaljer på meddelandenivå: Alumio iPaaS loggar vad varje meddelande innehöll och var det stoppade, så att teamet kan åtgärda det faktiska felet istället för att gissa sig till det
- Återkörning: Lagring inom Alumio iPaaS sparar dessa meddelanden, så att ett korrigerat flöde kan köras igen mot den order som orsakade felet
- Kontrollerad driftsättning: versionshantering och stegvis driftsättning gör att ändringar flyttas till produktion på ett kontrollerat sätt, istället för att redigera det som redan körs
Alumio iPaaS tillhandahåller även ett inspektionsverktyg. Det visar indata och utdata för varje transformeringssteg sida vid sida, så att teamet kan testa en del av ett flöde utan att köra hela integrationen. Dessa funktioner fungerar likadant för alla flöden, vilket gör att den andra integrationen kan återanvända testmetodiken från den första.
Vad ärlig integrationstestning ger ett företag
Fullständig täckning är inte möjlig att uppnå, och en testplan som skrivs som om den vore det är antingen oärlig eller blir aldrig färdigställd. Det användbara målet är en tydlig lista: vilka vägar teamet har testat ordentligt, vilka som bara har simulerats och vilka som inte kunde nås alls. Ett team som känner till sina otestade vägar kan hålla extra uppsikt över dem och agera snabbt, vilket är betydligt bättre än att tro att allt är testat.
En integrationsplattform gör det möjligt att hålla den listan uppdaterad. Den samlar flödet som testas och flödet som driftsätts på samma plats, sparar en logg över vad varje meddelande gjorde och gör det möjligt att kontrollera en rättelse mot den order som faktiskt orsakade felet.
Företaget får driftsättningar med färre överraskningar, fel som kan förklaras utifrån loggar istället för att behöva rekonstrueras i efterhand, samt tryggheten att kunna ändra i ett anslutet system utan att se det som en projektrisk.